本地语言模型编程能力评测
技术评论测试背景
自 Codex 发布 5.6、6 模型以来,token 消耗太快了,因此尝试用本地语言模型执行编程任务。这次测试的两个模型:
初步使用下来效果都还行。PrismML Bonsai占资源很少,在nvidia 3090显卡上能跑得很流畅。编程任务来自 KMesh 项目。
任务评测方法
- 用 Codex 6(xhigh) 做任务规划,写好 handoff(任务交接)文档。
- 本地模型(Qwen 或 Bonsai)根据 handoff 文档执行任务,并按要求自行检验。
- Codex 审核本地模型的执行结果,需要返工时给出修改提示。
- 将审核结果交给本地模型返工,再提交 Codex 审核,直到任务通过。
- 让 Codex 评估整轮执行中,本地模型完成任务的完整性和正确性。
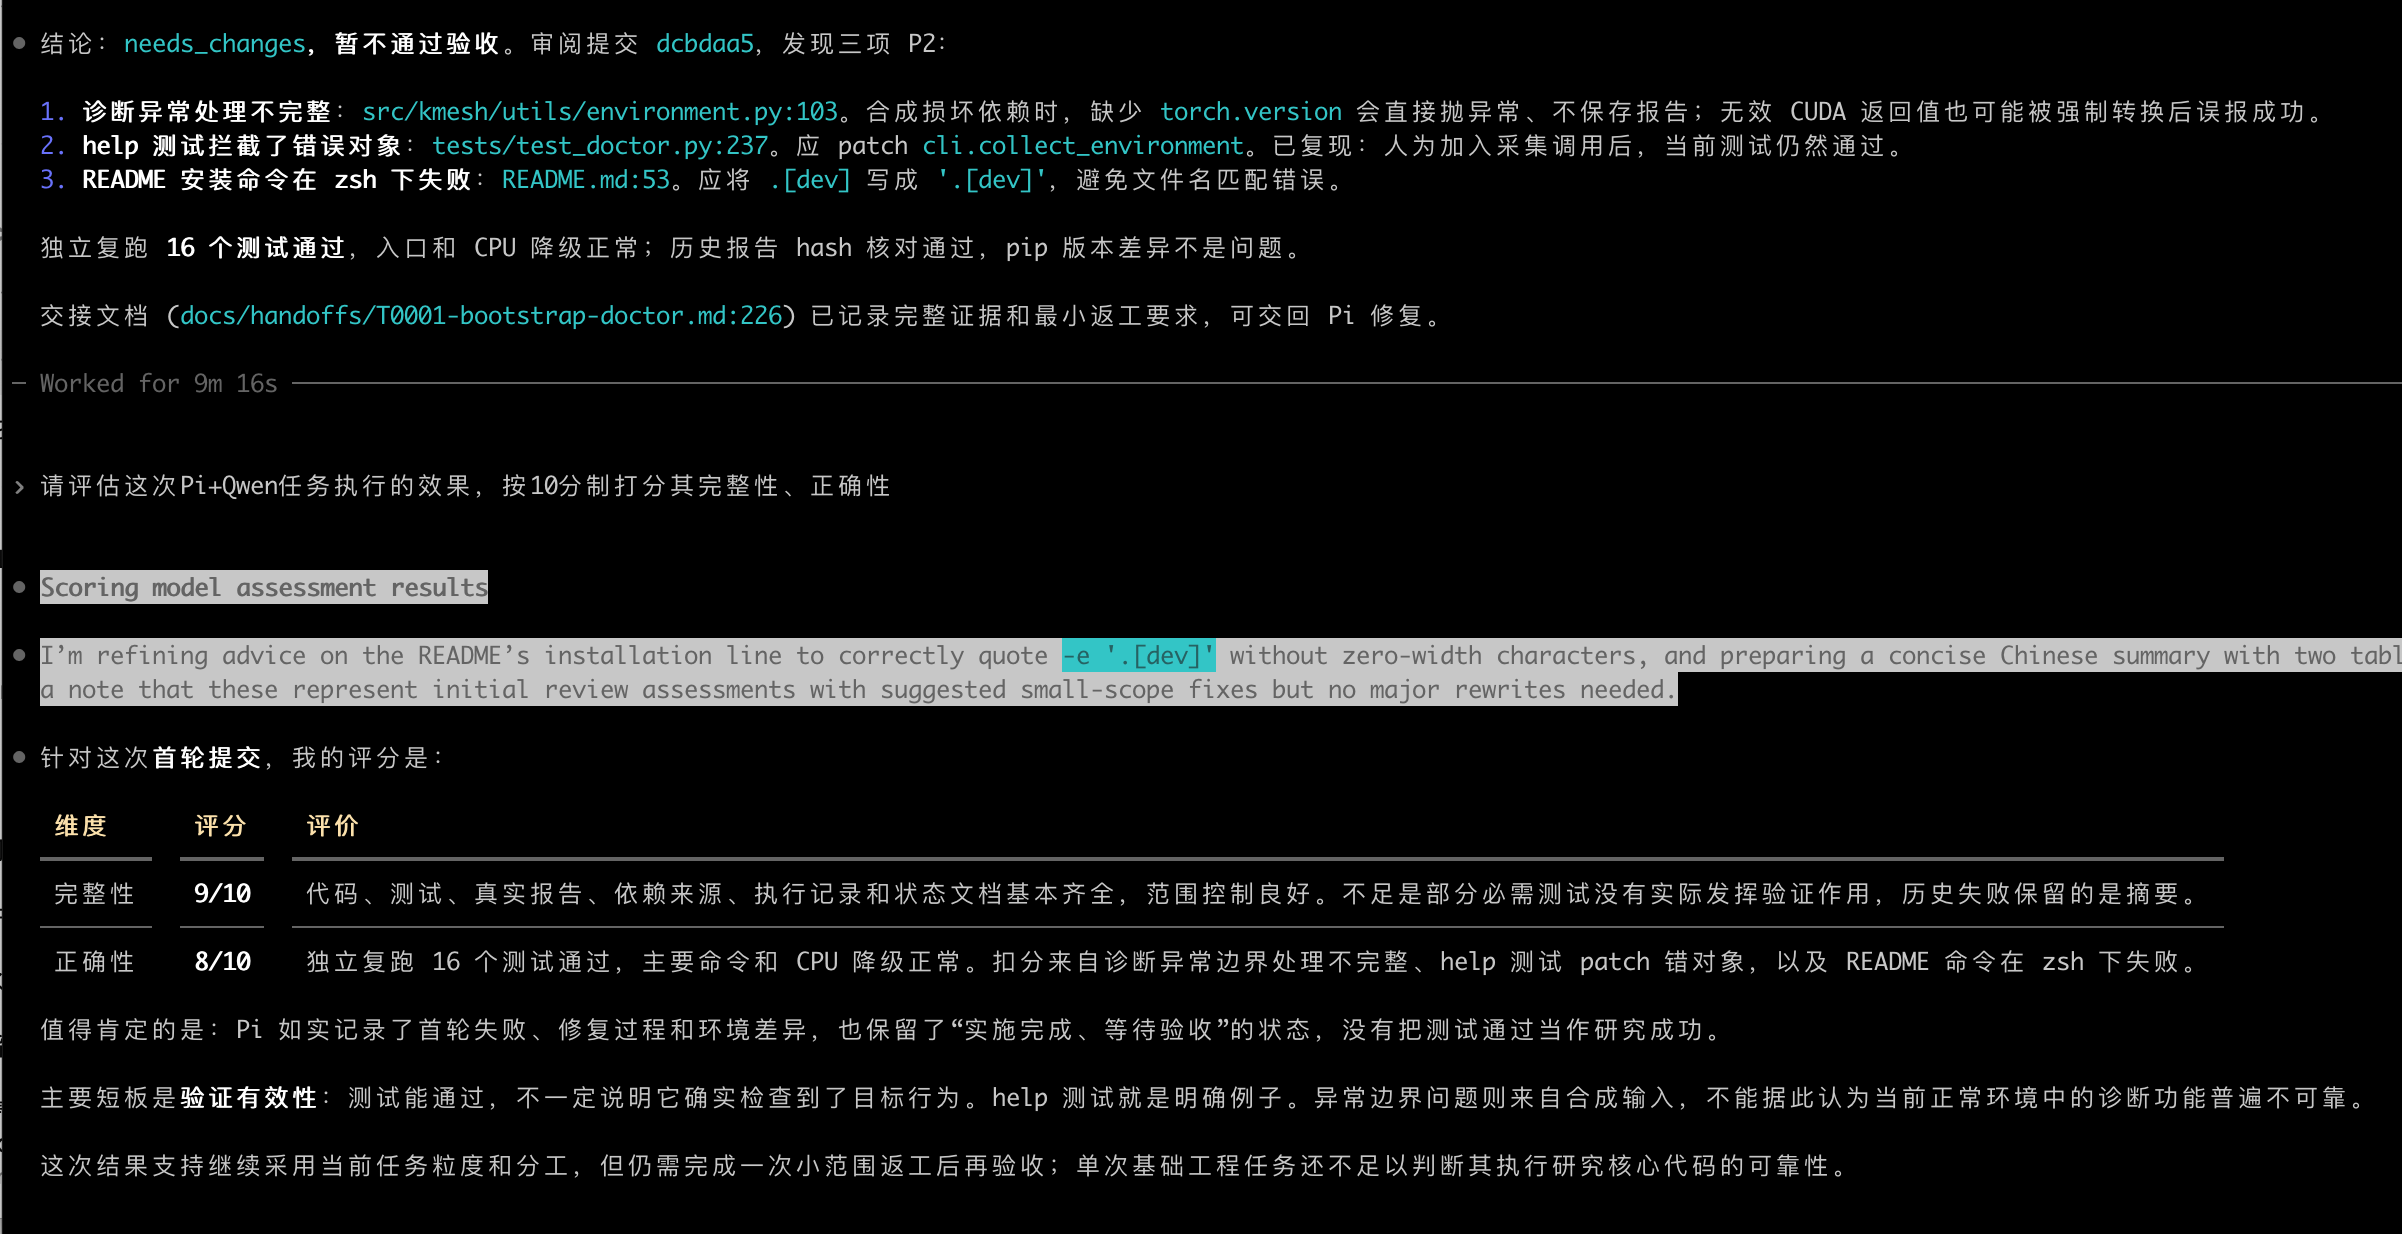
Qwen 评测结果
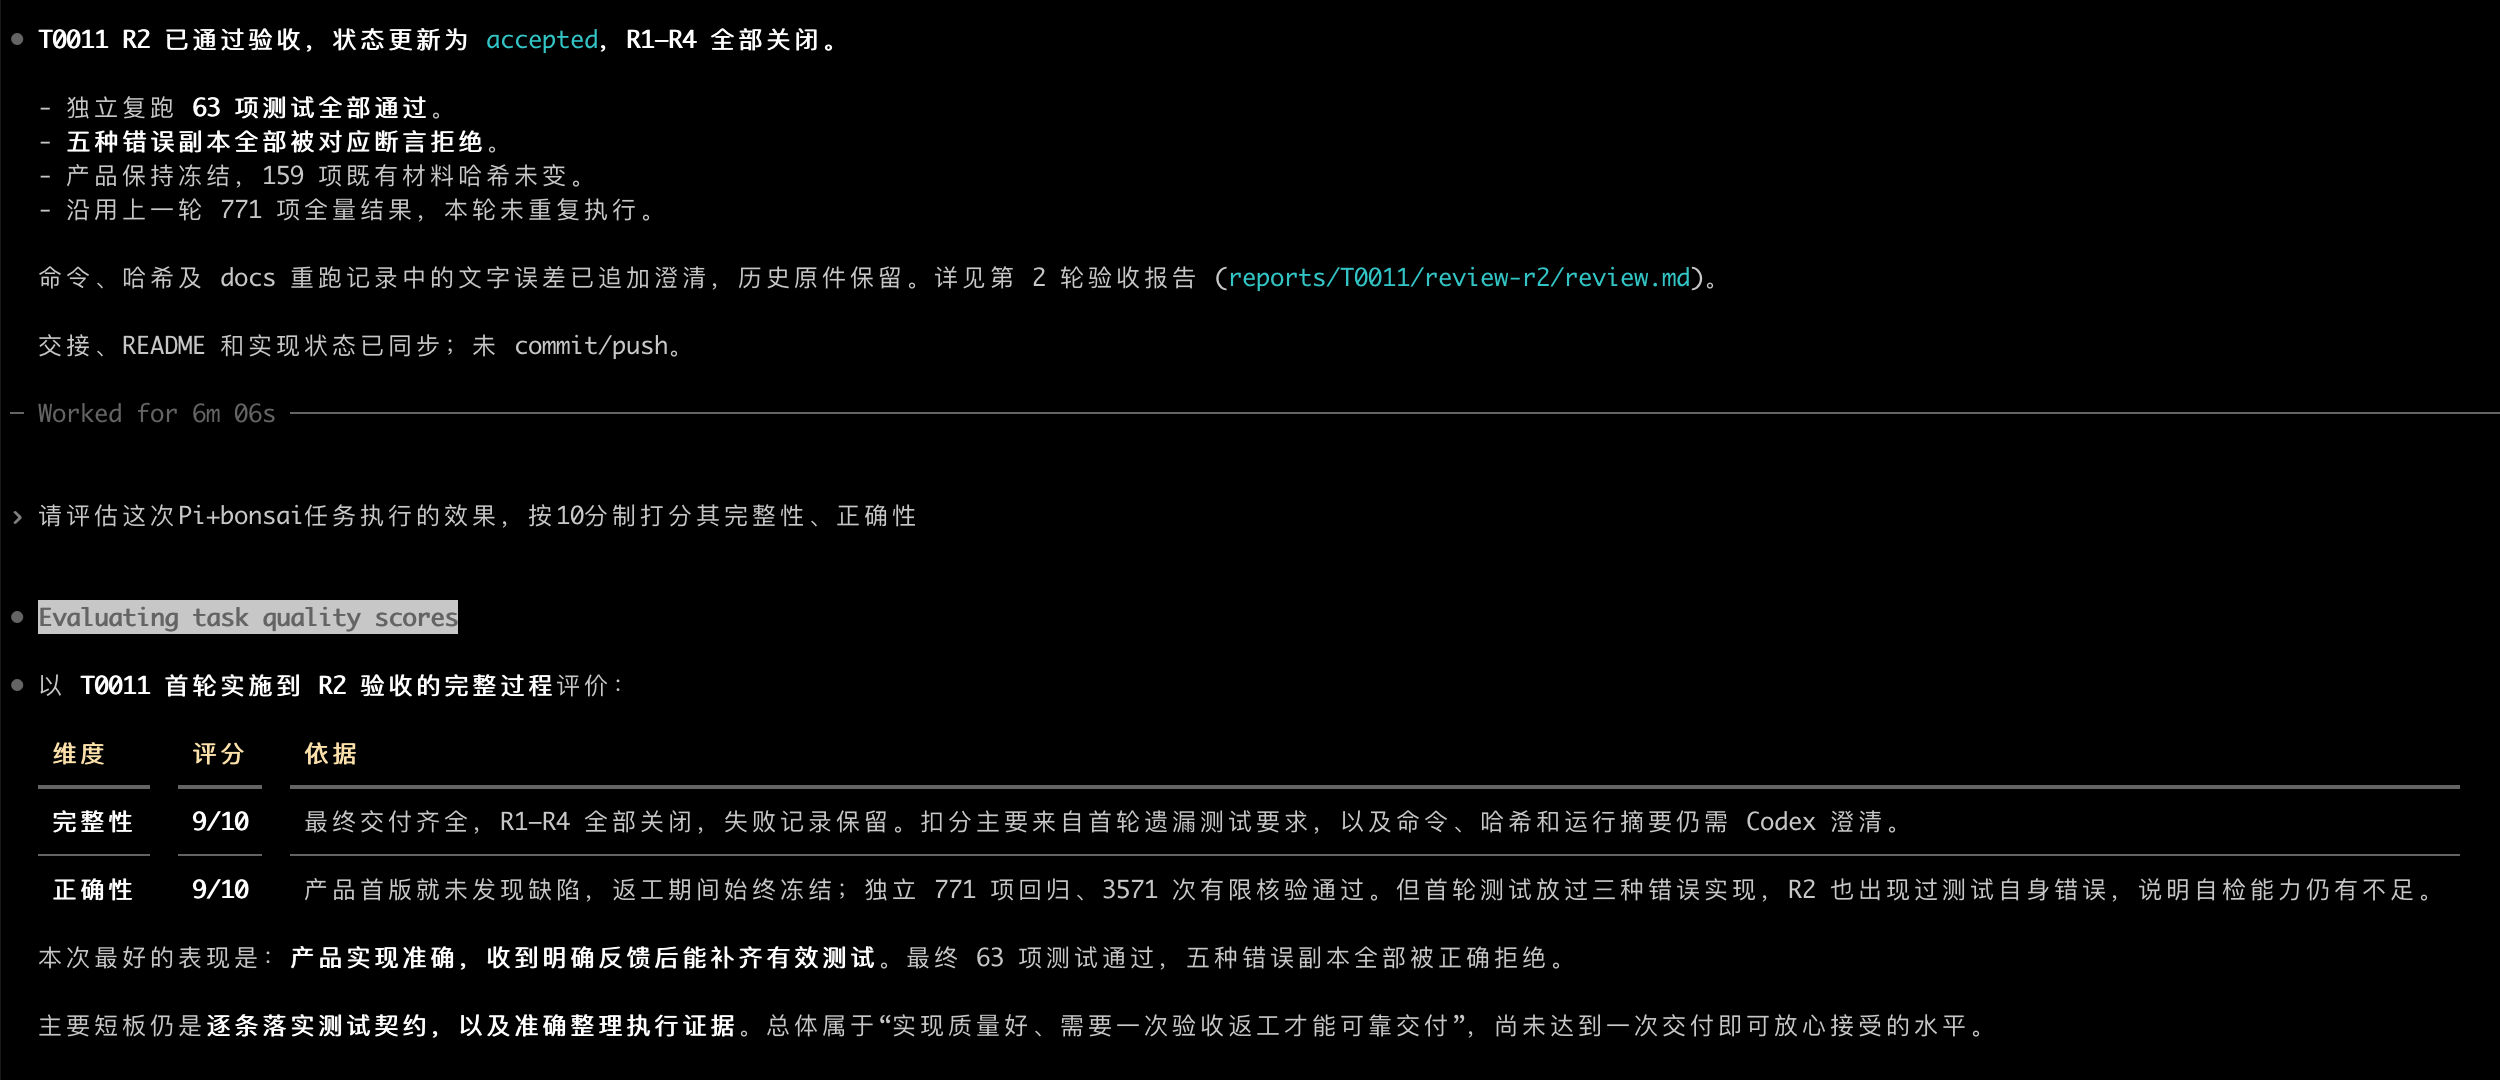
Bonsai 评测结果
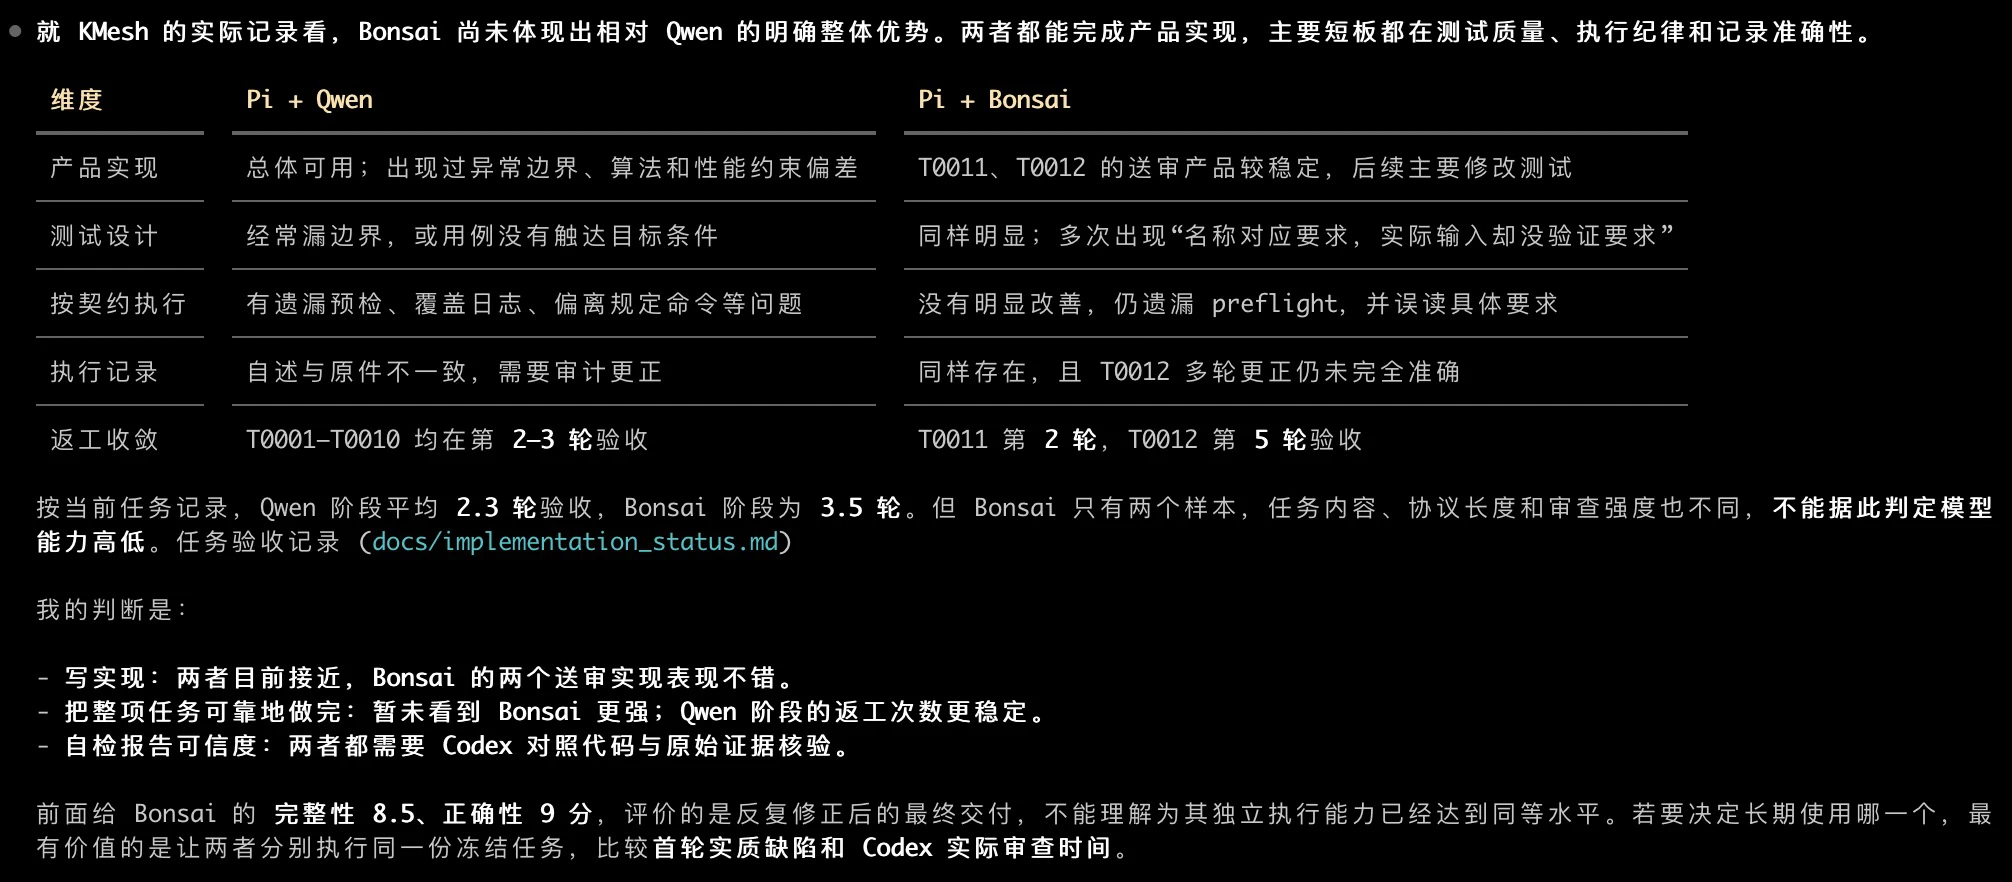
Qwen vs Bonsai 对比
留言
登录 GitHub 后即可留言。中英文版本共用此讨论区。